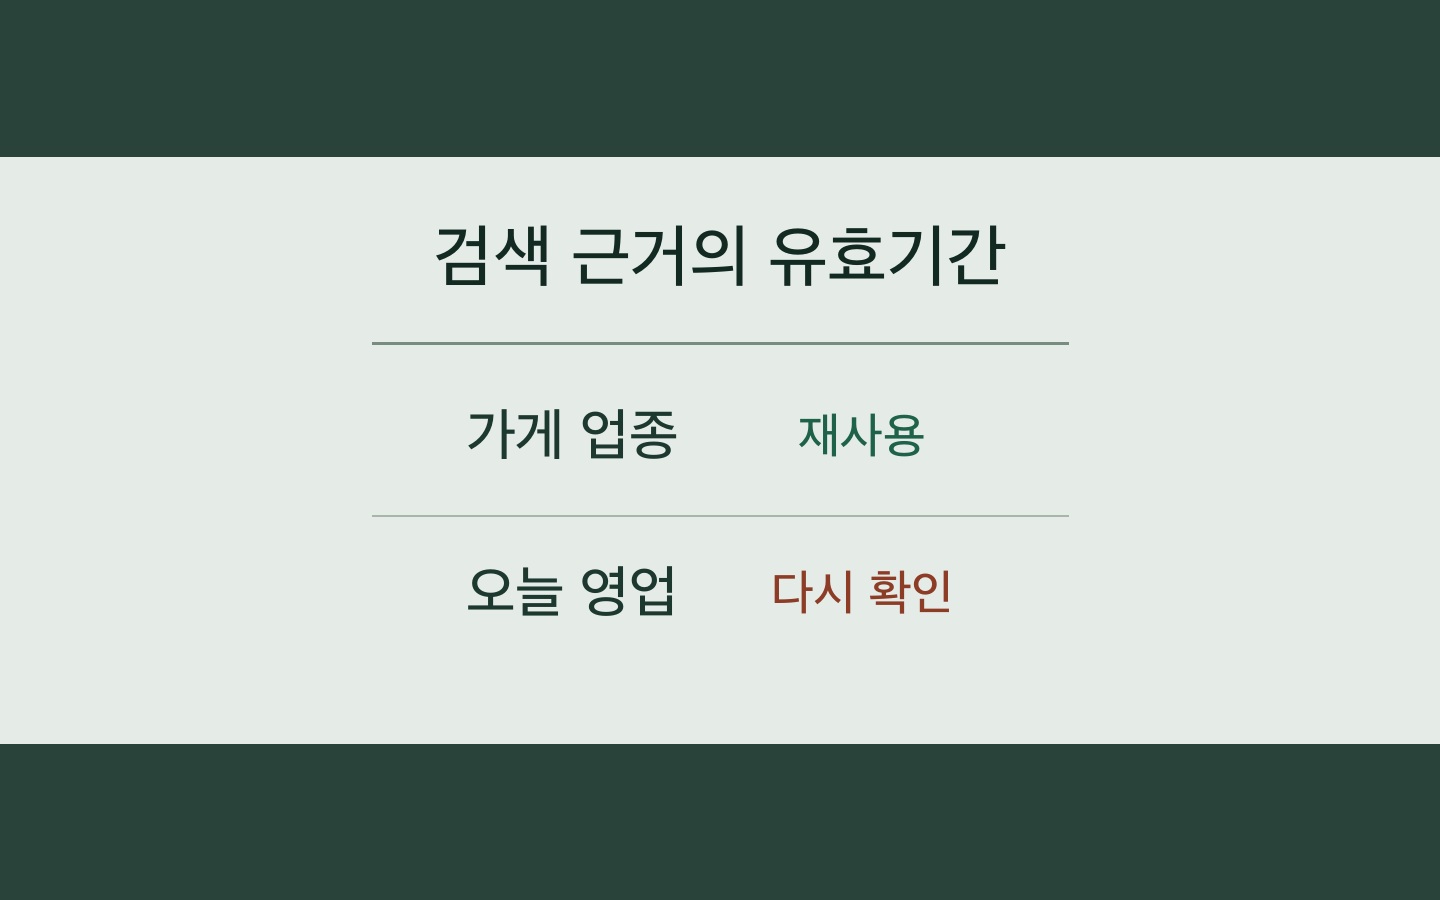
가게 이름을 검색할 때는 두 종류의 질문이 섞이기 쉽다. 이 가게가 빵집인지 묻는 것과 오늘 문을 여는지 묻는 것이다. 빵집이라는 사실은 어제 확인한 걸 가져와도 대체로 괜찮다. 휴일의 영업시간은 어제 답을 그대로 가져오면 곤란하다. 둘 다 웹에서 찾을 수 있다는 이유로 같은 방식으로 처리할 필요는 없다.
DoorDash가 10월 29일 공개한 글에는 이 차이를 다룰 수 있는 구조가 나온다. 모델의 검색 기능을 켜면 한 번의 호출로 결과를 받을 수 있다. 대신 어떤 검색을 몇 번 했는지, 다음 호출에서도 그 근거를 써도 되는지, 검색 자체에 얼마를 썼는지 따로 다루기 어렵다. DoorDash는 검색을 별도 도구로 떼어 내고 모델에는 제목, URL, 짧은 내용을 돌려주는 공통 형식을 만들었다.
사례의 숫자도 분모를 같이 보면 이해하기 쉽다. 일반 소매 검색어 7,988건에서 저자들이 보고한 검색료는 1,000건당 7.90달러에서 0.11달러로 바뀌었다. 같은 비교에서 검색 의도 분류 정확도는 93.40%와 93.90%였다. 모델 추론료는 이 비용에 포함되지 않는다. 반대로 최신 답이 중요한 FreshQA에서는 실험에 쓴 다섯 모델 모두 내장 검색 쪽 성적이 높았다. 같은 회사의 글에서 두 결과를 함께 보여준다는 점이 좋았다.
검색어보다 근거의 유효기간부터 정한다
예를 들어 동네 가게를 찾는 작은 서비스를 만든다면, 이름과 업종을 분류할 때는 출처 URL, 조회 시각, 어떤 항목을 확인했는지를 같이 저장하겠다. 오늘 영업 여부를 묻는 요청에는 그 저장값을 답으로 쓰지 않고, 가게의 공지처럼 현재 날짜를 확인할 수 있는 근거를 다시 찾는다. 찾지 못했다면 영업 중이라고 채우지 않는다. ‘업종은 빵집, 오늘 영업 여부는 확인 안 됨’이면 그다음 화면에서도 두 값을 섞지 않고 표시할 수 있다.
비용을 비교할 때도 처음에는 전체 평균 하나만 보지 않는 게 좋겠다. 새로 검색한 요청과 재사용한 요청, 원래 검색어와 뜻이 비슷하다고 판단해 재사용한 요청을 나눠 보면 어느 쪽에서 틀렸는지 알 수 있다. 같은 동네에 이름이 비슷한 가게 두 곳을 합쳐 버리는 경우라면, 검색을 덜 했다는 숫자는 도움이 안 된다. 이름뿐 아니라 주소와 확인 날짜도 남겨야 왜 답이 어긋났는지 나중에 볼 수 있다.
예전에는 검색이 원하는 답을 어떻게 보여줄지를 생각했다. 답을 만드는 쪽에서 보면, 먼저 정해야 할 것은 답마다 얼마나 오래 믿을 수 있느냐에 가까웠다. 한 번 더 검색할지의 기준도 그다음에야 생긴다.